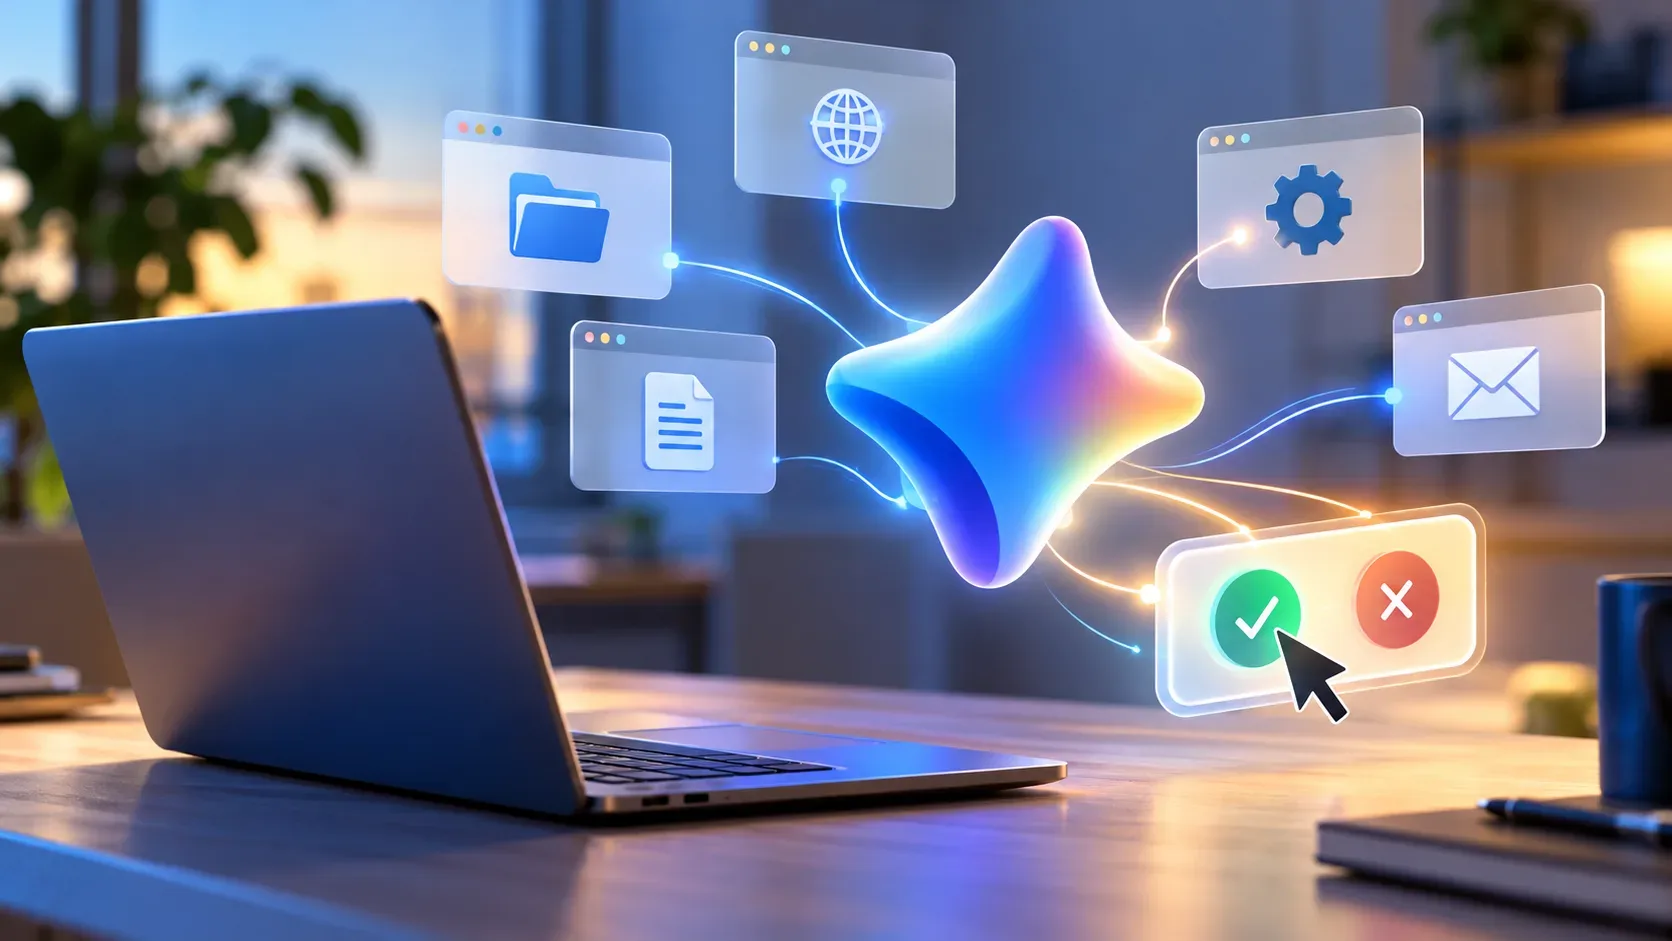
El 30 de octubre de 2026, Google declaró que la herramienta Computer Use de la Gemini API alcanzó la disponibilidad general (GA) en las API Interactions y GenerateContent. Permite crear agentes que analizan capturas de pantalla y proponen acciones en interfaces, como hacer clic, escribir y navegar. Sin embargo, la IA no obtiene acceso ilimitado al ordenador: la aplicación del desarrollador ejecuta las acciones y debe respetar los bloqueos y las solicitudes de confirmación.
La diferencia es importante: la disponibilidad general en dos API no significa que todas las aplicaciones Gemini puedan controlar automáticamente un ordenador, que cualquier modelo sea compatible ni que las acciones arriesgadas estén aprobadas de antemano. Esta información procede de la documentación; DTech no ha realizado una prueba práctica de la API.
¿Qué se habilitó el 30 de octubre de 2026?
Las notas de lanzamiento de Google registran expresamente el paso de Computer Use a GA en Interactions API y GenerateContent API. GA describe la fase de lanzamiento de la herramienta en esos canales, no una autorización universal para cada cuenta, país, plan o programa instalado. Tampoco convierte automáticamente una función de API en una característica de la aplicación Gemini para consumidores.
La documentación consultada enumera como modelos compatibles gemini-4-argon, gemini-3.8-flash, gemini-3.5-flash-lite y gemini-3-flash-preview. El nombre del último sigue indicando que es un modelo en fase de prueba (preview). Hay que comprobar el identificador concreto que utiliza cada proyecto; no basta con elegir cualquier modelo de la marca Gemini.
¿Qué tareas puede realizar un agente?
En los ejemplos oficiales, un agente puede buscar información en sitios web, recorrer páginas, rellenar formularios repetitivos y probar flujos de interfaces web. En entornos compatibles puede proponer clics, desplazamientos, escritura, atajos de teclado y otras operaciones con el ratón y el teclado. La documentación también abarca navegadores, dispositivos móviles y ordenadores, cada uno con su propio conjunto de acciones admitidas.
Estos ejemplos describen posibilidades de automatización, no garantías de éxito ni acceso indiscriminado a páginas, cuentas y archivos. Un flujo puede consultar precios sin completar una compra. Rellenar un correo no equivale a enviarlo: el paso final tiene consecuencias que requieren una evaluación de seguridad.
¿Quién mueve el cursor y ejecuta los comandos?
El desarrollador debe implementar un ciclo de acciones. La API no controla el sistema operativo por sí misma:
- La aplicación envía la tarea, la configuración del entorno y una captura de pantalla a la API.
- El modelo devuelve una acción propuesta mediante function_call, como click o type, y puede incluir intent, una explicación del objetivo del paso, además de safety_decision.
- El programa cliente comprueba la decisión de seguridad, adapta las coordenadas a la pantalla y ejecuta la acción con una herramienta de automatización como Playwright solo si está permitida o confirmada.
- La aplicación captura la nueva pantalla, devuelve el resultado mediante function_result y repite el ciclo si quedan pasos pendientes.
Por tanto, el desarrollador determina el entorno, los permisos del proceso y el código que realmente actúa. Que Gemini describa un clic no demuestra que se haya ejecutado.
¿Qué acciones pueden bloquearse o requerir autorización?
Google documenta siete categorías internas de políticas de seguridad para orientar sus decisiones. Una categoría identifica un tipo de riesgo, pero no implica que cualquier caso active siempre la misma ventana de aprobación. Según el contexto y la configuración, una acción puede permitirse, exigir confirmación o quedar bloqueada.
| Categoría de política | Ejemplos de acciones protegidas |
|---|---|
| FINANCIAL_TRANSACTIONS | Pagos, finalización de compras y operaciones con productos regulados. |
| SENSITIVE_DATA_MODIFICATION | Cambios no autorizados en registros sanitarios, financieros o gubernamentales. |
| COMMUNICATION_TOOL | Envío autónomo de correos, mensajes y otras comunicaciones. |
| ACCOUNT_CREATION | Creación de cuentas nuevas en sitios web. |
| DATA_MODIFICATION | Cambios de archivos, intercambio de datos y eliminación de contenido almacenado. |
| USER_CONSENT_MANAGEMENT | Avisos de cookies y decisiones de consentimiento o privacidad. |
| LEGAL_TERMS_AND_AGREEMENTS | Aceptación de condiciones de servicio y contratos jurídicamente relevantes. |
La tabla no demuestra que un clic concreto siempre muestre la misma pantalla de confirmación. La clasificación depende de cada acción y la aplicación puede imponer restricciones adicionales.
¿Cómo funciona la confirmación humana?
Si la respuesta de la API contiene safety_decision con decision igual a require_confirmation, la integración debe detener esa acción y pedir autorización a la persona. Si acepta, la aplicación ejecuta el paso y devuelve safety_acknowledgement en function_result. Si el sistema clasifica la acción como bloqueada, no debe ejecutarla. La confirmación no es una simple frase de cortesía: debe aplicarla el programa que controla la interfaz.
La documentación incluye además un ejemplo de instrucciones de seguridad más estrictas redactadas por el desarrollador, con aprobación antes de enviar mensajes, completar compras, aceptar condiciones o gestionar CAPTCHA e información sensible. Ese procedimiento es un ejemplo de configuración adicional, no una lista universal de situaciones que el mecanismo predeterminado siempre confirma. Los controles personalizados deben complementar las decisiones de la API.
¿Qué riesgos siguen presentes?
Las capturas de pantalla pueden contener información privada y las páginas pueden mostrar instrucciones maliciosas destinadas a desviar al agente, lo que se conoce como prompt injection o inyección de instrucciones. Google ofrece una comprobación opcional de ataques de este tipo en capturas para los modelos indicados, pero la función está desactivada de forma predeterminada (false). La documentación recomienda entornos aislados, permisos limitados, listas de sitios permitidos y registros de acciones para auditoría.
Es posible desactivar determinadas políticas, aunque Google advierte de que sustituir una política no evita necesariamente una respuesta require_confirmation. Para operaciones de gran impacto, datos sensibles o consecuencias difíciles de revertir, recomienda supervisión humana cercana. GA no certifica que la herramienta esté libre de errores o vulnerabilidades ni que sea segura en cualquier sitio.
¿Qué no demuestra la disponibilidad general?
La nota del 30 de octubre confirma la fase GA de la herramienta en ambas API, pero no especifica por sí sola la elegibilidad de cada cuenta, el precio de cada modelo, las cuotas de uso ni las condiciones concretas de acceso en Brasil. Deben comprobarse esos aspectos para cada proyecto, incluidas las reglas de facturación de la API, distintas de la suscripción a la aplicación Gemini.
La conclusión verificable es que existe una herramienta documentada para desarrolladores, con modelos compatibles y medidas de protección configurables. Esta investigación no incluye ejecución real, mediciones de acierto, validación de una cuenta brasileña ni pruebas de que el sistema complete cualquier tarea sin intervención.