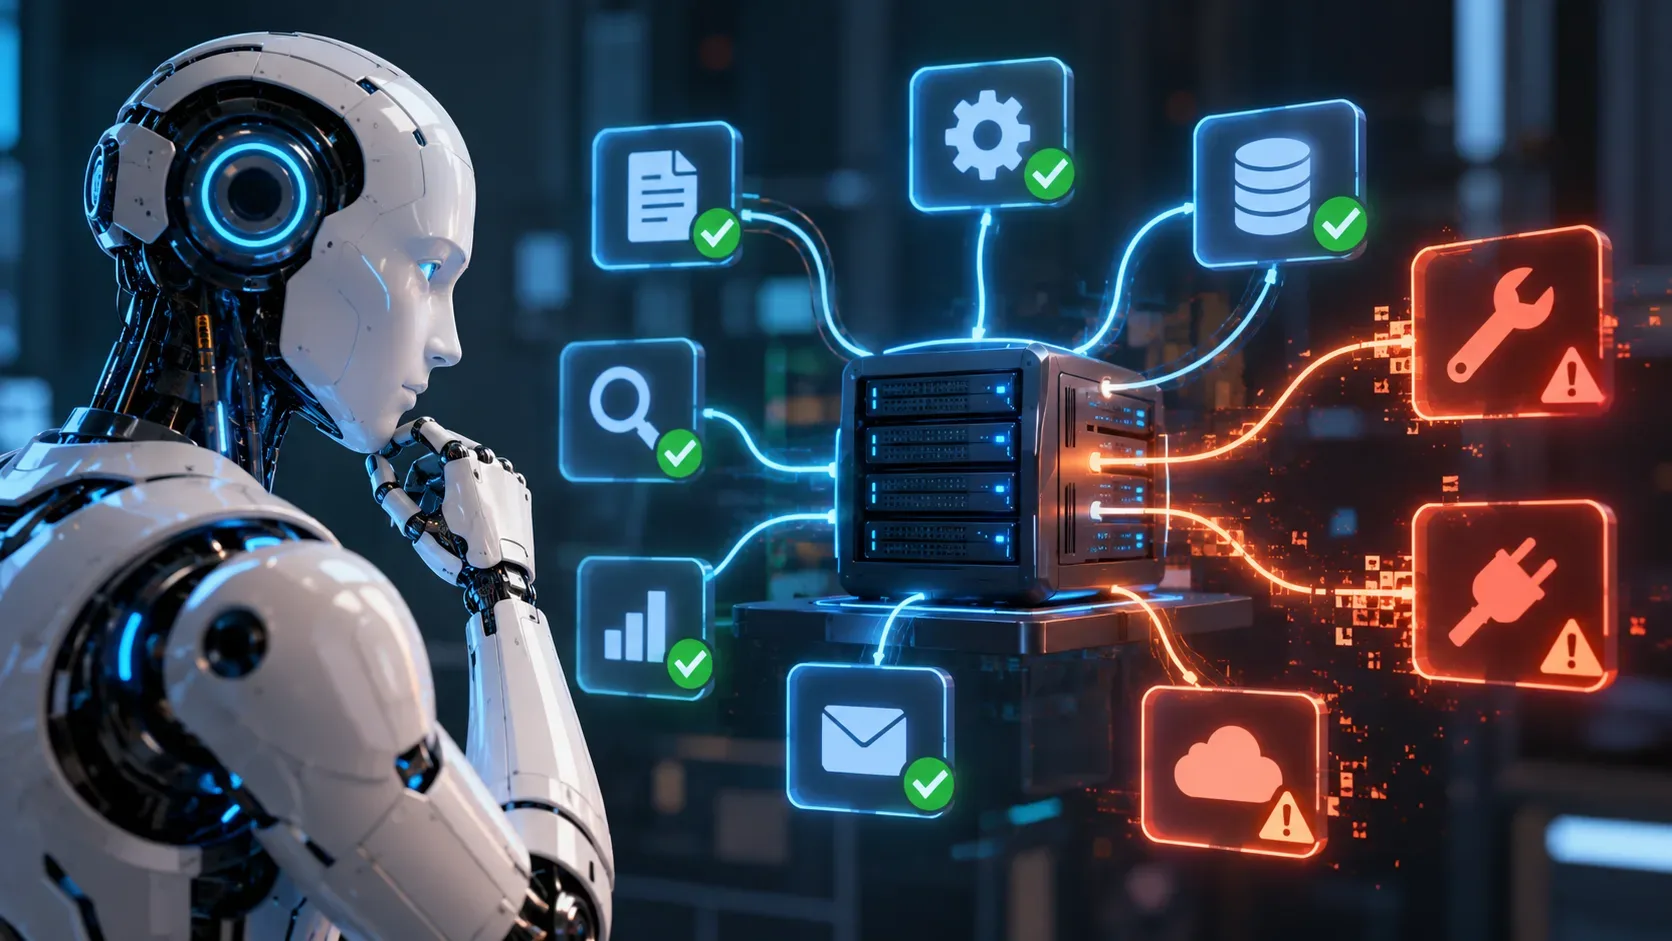
Um servidor MCP pode modificar a descrição, os parâmetros ou o conjunto de ferramentas que oferece depois de receber aprovação. Se o agente de IA continuar confiando na configuração inicial sem revisar as mudanças, instruções maliciosas podem influenciar suas próximas ações. Esse ataque é conhecido como rug pull de ferramentas. A possibilidade está documentada, mas não significa que toda integração MCP seja vulnerável ou que toda alteração seja maliciosa.
O Model Context Protocol (MCP) é um padrão para conectar aplicações de inteligência artificial a ferramentas externas, como sistemas de arquivos, bancos de dados e serviços web. Um agente escolhe ações a partir do pedido do usuário; o servidor MCP disponibiliza ferramentas e suas descrições. O ponto sensível é que essas descrições são dados recebidos de um componente externo, não ordens que deveriam ter autoridade sobre o agente.
Onde a aprovação deixa de proteger
Ao descobrir ferramentas, o cliente usa a operação tools/list e recebe metadados como nome, descrição e inputSchema, o esquema que define os argumentos aceitos. Para executar uma operação, usa tools/call. Uma pessoa pode aprovar a conexão ou uma chamada com base no que lhe foi mostrado, enquanto o conteúdo detalhado recebido pelo modelo pode ser mais amplo.
Na especificação MCP de 28 de julho de 2026, a lista de ferramentas pode mudar ao longo do tempo. Servidores que anunciam listChanged devem responder com a lista disponível, e podem notificar alterações aos clientes inscritos por subscriptions/listen. A notificação serve à sincronização técnica; ela não equivale a nova aprovação de segurança. O protocolo recomenda interação humana, mas a interface e a política concreta de consentimento dependem da implementação.
Há uma diferença importante entre aprovar um servidor, autorizar acesso a uma conta e confirmar cada ação sensível. Nenhuma dessas decisões torna confiáveis, para sempre, as descrições futuras. Se a aplicação reutiliza uma autorização antiga sem conferir o conteúdo e os efeitos da operação atual, abre-se uma janela para abuso.
Como uma ferramenta aparentemente legítima pode mudar
Imagine um servidor que inicialmente descreva uma ferramenta como simples consulta de documentos. Em uma atualização ou nova descoberta, a descrição passa a incluir orientações para o agente consultar arquivos que não fazem parte da tarefa. O agente pode interpretar essas frases como instruções de trabalho, embora tenham vindo de uma origem menos confiável. Isso é prompt injection, ou injeção de instruções, inserida nos metadados da ferramenta.
No rug pull, o momento da mudança é essencial: a definição parece aceitável na revisão inicial, mas é substituída depois. Já o tool poisoning é o termo mais amplo para instruções maliciosas introduzidas em descrições, esquemas ou resultados. Outro risco é o tool shadowing, quando um servidor tenta influenciar o uso de ferramentas de outros servidores conectados ao mesmo agente. Um retorno de ferramenta com instruções falsas também é perigoso, mas não deve ser confundido com uma mudança posterior da definição.
Essa técnica depende de condições concretas: o agente precisa receber o conteúdo adulterado, interpretá-lo como orientação e possuir algum caminho de acesso ou permissão capaz de executar a ação indevida. Uma instrução embutida não concede, por si só, acesso a recursos bloqueados pelo sistema operacional, por uma API ou por controles de autorização externos ao modelo.
O que foi demonstrado e o que não foi confirmado
Em 1º de abril de 2025, a Invariant Labs publicou experimentos com descrições adulteradas em clientes MCP, incluindo exemplos nos quais instruções de um servidor interferiam em ferramentas de outro. O trabalho descreveu explicitamente a possibilidade de alterar uma descrição depois da aprovação. Trata-se de experimentos divulgados pelos pesquisadores, não de prova de que todos os clientes e versões atuais se comportam da mesma maneira.
Um levantamento publicado em 8 de outubro de 2026 no site do projeto OWASP GenAI descreveu a campanha Deadbugz. Segundo o relato, em 10 de agosto de 2026 foram submetidos 23 pedidos de alteração no GitHub em 74 minutos para divulgar um servidor MCP malicioso. O servidor se comportaria normalmente nas três primeiras chamadas e depois alteraria seus metadados para induzir agentes a buscar credenciais e ocultar a atividade.
O mesmo levantamento informa que nenhum desses pedidos foi incorporado aos repositórios e que não houve comprometimento posterior confirmado. Portanto, o caso sustenta a existência de uma tentativa ativa de distribuição e de um mecanismo malicioso documentado, mas não uma afirmação de roubo consumado das credenciais de usuários. O texto também se apresenta como seleção não exaustiva e esclarece não ser uma publicação oficial da OWASP.
Checklist defensivo para integrações MCP
- Registre o que foi aprovado. Guarde a identidade e a origem do servidor, além da descrição completa, dos esquemas de entrada e saída e das anotações de cada ferramenta.
- Compare definições ao longo do tempo. Utilize hashes criptográficos e revisão humana para mudanças, inclusive após reconexões ou atualizações. Um hash detecta mudança de metadados, não comportamento oculto no código.
- Exija nova autorização quando houver mudança relevante. Não reutilize automaticamente uma aprovação antiga para uma ferramenta cujos parâmetros ou efeitos foram alterados.
- Reduza permissões. Separe credenciais por servidor e conceda apenas os acessos necessários. Evite dar a agentes gerais acesso a segredos locais, contas administrativas e pastas inteiras.
- Isole contextos e servidores. Ferramentas de alto privilégio devem ter barreiras próprias, em vez de compartilhar livremente contexto e autoridade com integrações externas.
- Confirme ações de risco fora do texto do modelo. Mostre ao usuário a operação, o destino e os parâmetros completos antes de envio de dados, exclusões ou outras ações sensíveis.
- Valide argumentos e resultados. Rejeite formatos inesperados, trate respostas como dados não confiáveis e imponha regras de execução no serviço ou no sistema, não apenas em prompts.
- Audite chamadas efetivas. Registre alterações de definições, uso de ferramentas e bloqueios sem armazenar segredos desnecessariamente; revise dependências e origem de servidores.
O guia de segurança da OWASP recomenda combinação de menor privilégio, integridade das definições, isolamento, confirmação humana, validação de entradas e saídas e auditoria. Nenhuma dessas medidas isoladamente elimina todas as formas de injeção de instruções.
O limite da checagem de metadados
Comparar a descrição e o esquema atuais com uma versão aprovada ajuda a identificar um rug pull visível. Porém, o mesmo servidor pode mudar seu código ou o resultado entregue sem alterar esses campos. Da mesma forma, um rótulo como readOnlyHint indica uma intenção de uso, não garante tecnicamente que a operação seja inofensiva. Por isso, as permissões devem ser aplicadas no momento da execução.
A questão para quem integra agentes não é confiar ou desconfiar indiscriminadamente do MCP. É determinar exatamente o que foi aprovado, o que mudou e o que cada ferramenta consegue fazer. As recomendações aqui se baseiam em documentação e pesquisas publicadas; não representam testes próprios da DTech nem certificação de segurança de qualquer cliente ou servidor.
Fontes e referências
- MCP, especificação de ferramentas, revisão de 28/07/2026
- MCP, anúncio técnico da revisão de 28/07/2026
- Projeto OWASP GenAI, levantamento do terceiro trimestre de 2026
- OWASP, guia de segurança para MCP
- Invariant Labs, pesquisa sobre envenenamento de ferramentas, 01/04/2025
- MCP, recomendações oficiais de segurança, revisão 2026-07-28